W3
扩容方案进阶预计 35-45 分钟9 个步骤12 次学习

ZK 从原理到 Rollup:证明系统与 zkEVM 四类

把「零知识证明」从一个玄学名词拆成可理解的工程构件:证明者与验证者在证明什么、完备性/可靠性/零知识这三个性质各解决什么问题、为什么需要多项式承诺(KZG 与 FRI 的差别)、SNARK 与 STARK 在可信设置与证明体积上如何取舍。然后回到 Rollup:有效性证明(validity proof)在 L2 里承担的角色、为什么「证明生成很贵、链上验证很便宜」是这门技术的核心经济性、zkEVM 四个类型(Type 1 到 Type 4)各自牺牲了什么。最后必须澄清一个高频误解:<strong>持有 ZK 并不等于隐私</strong>——zkRollup 的交易细节默认仍然是公开的。

⚠️
操作前必读

这一章主要建立判断力,不涉及直接操作资金,但有一个现实风险必须点明:「ZK」这三个字母被大量营销滥用。见到项目宣传自己「用了 ZK」时,请分清三件事:一、它用 ZK 是为了压缩证明、做可验证计算(技术手段),还是为了隐藏交易内容(隐私目标)?

两者完全不是一回事。二、它的 prover(证明生成)是去中心化网络还是项目自己的一台服务器?若证明由单一实体生成、且链上验证只认这一家的输出,那么「有效性证明」带来的信任与「一个多签」差别有限。

三、跨链时不要因为对方标了 ZK 就自动给高信任,仍需按「数据放哪里、提现多久、桥由谁控制」三条检查。

01

零知识证明到底在证明什么

登录记录进度

先去掉神秘感。零知识证明(Zero-Knowledge Proof)是为了解决一个很朴素的信任问题:我手里有一份证据,但我不想把证据本身给你,我只想让你相信「我知道这份证据」。

形式化地说:证明者(Prover)要向验证者(Verifier)证明「我知道一个值 w,使得公开函数 f(x, w) = true」,而验证者除了「这个陈述为真」之外,什么都学不到。举个区块链里的具体例子:假设某笔转账要满足「转账之后我的余额仍然非负」,我不想公开我的全部余额明细,但我想让你相信这个条件成立——零知识证明允许我把这个条件变成一个数学陈述并给出证明。

关键认知:ZK 证明的是「某个计算被正确执行了」,它默认不隐藏输入本身。 你以为的「ZK 等于匿名」,其实需要额外的隐私设计才能实现。

💡
小技巧:

把 ZK 理解成「可验证的计算摘要」,而不是「加密」。它能证明「我算对了」,但不自动保证「你看不到我算了什么」。
02

三个性质:完备性、可靠性、零知识

登录记录进度

一个能称为「零知识证明」的方案必须同时满足三条,缺一条就不成立。完备性(Completeness):如果陈述为真、且证明者诚实,那么验证者一定会被说服——这条保证「真话总能被证明」。可靠性(Soundness):如果陈述为假,任何(哪怕算力无限的)作弊证明者都无法让验证者相信——这条保证「假话永远骗不过」。

工程实践中常讨论知识可靠性(knowledge soundness):不仅陈述为真,证明者还必须真的知道那个证据,防止「瞎蒙也蒙对」。零知识(Zero-Knowledge):验证者除了「陈述为真」之外学不到任何额外信息——这条是隐私的来源。

你可以用一句话记住三者的分工:完备性防「冤枉好人」,可靠性防「放过坏人」,零知识防「顺带泄露」。 在 Rollup 场景里,最被依赖的是前两条,第三条反而是可选的——这正说明「zkRollup 不等于隐私链」。

03

为什么需要多项式承诺:KZG 与 FRI

登录记录进度

要让验证者相信「一大段计算是对的」,需要一种能把大规模数据压缩成一个极短的承诺、并支持抽查的技术,这就是多项式承诺(Polynomial Commitment)

直觉是:把待验证的数据编码成多项式的一部分,验证者随机挑几个点让你「打开」,如果你能每次都打开正确,就极大概率说明整段数据没问题。主流两派:KZG 承诺依赖可信设置(trusted setup)——需要在仪式中生成一组参数,只要有一方诚实地销毁了自己的随机数,整套系统就是安全的;它的优点是承诺与证明都很小(一个椭圆曲线点或几十字节),链上验证便宜,这也是以太坊 EIP-4844 里 blob 承诺采用 KZG 的原因。

FRI(Fast Reed-Solomon Interactive Oracle Proofs)是另一派,不需要可信设置(属于透明设置),代价是证明体积更大、验证计算更多,但避免了「仪式被做过手脚」这一整类风险。

两条路线的取舍,本质是「你要不要接受一次性的可信设置」。

💡
小技巧:

看到「需要可信设置」时不必恐慌,但要知道它的含义:安全性依赖仪式参与者中至少一人销毁了秘密。参与人数越多、流程越公开,这个假设越站得住。

04

SNARK 与 STARK 的取舍

登录记录进度

由承诺方案衍生出两大证明系统家族。SNARK(简洁非交互式知识论证):证明体积极小(几百字节)、验证极快,链上验证 Gas 低,但通常需要可信设置,且多数实现依赖椭圆曲线配对——不具备后量子安全性

STARK(可扩展透明知识论证):不需要可信设置、只依赖哈希函数,因此后量子安全、透明可审计,代价是证明体积大(几十到几百 KB,比 SNARK 大两三个数量级)、验证计算量更高,所以早期链上验证费用偏贵。

这解释了为什么不同项目选择不同:追求「链上验证最便宜」的倾向 SNARK,追求「不要可信设置、抗量子」的倾向 STARK(StarkNet 就是 STARK 路线的代表)。近年两个方向都在互相借鉴、迭代(比如更小的 STARK、混合方案),但没有免费的选择:你要么支付可信设置,要么支付证明体积。

理解这一点,看到「我们的证明只有 200 字节」或「我们无需可信设置」的宣传时,你就知道对方在强调哪个方向的取舍。

05

在 Rollup 里 ZK 是怎么被用上的

登录记录进度

回到 L2 场景。有效性证明(validity proof)在这里承担的角色是:L2 的排序器把一批交易执行完,得到新的状态根,然后生成一个证明「从旧状态根出发,按这批交易执行,一定得到这个新状态根」。

这个证明被提交到以太坊主网的合约里,主网合约验证通过后才接受这个新状态。与 Optimistic Rollup 的欺诈证明相比,差别在时间与信任结构:Optimistic 默认「先接受、有异议再挑战」,所以要等挑战期(通常 7 天)才能确认提现,期间靠「至少有一个诚实挑战者」这个假设;有效性证明则是提交时就必须证明对,因此提现无需等待挑战期,安全假设更少。

但代价是证明生成成本高、工程复杂(尤其 EVM 等价的证明极难做),且历史上各 zkRollup 的 prover 常由项目自己运营——这就是前面风险提示里说的「prover 集中化」,也是判断一个 zkRollup 成熟度最该看的指标之一。

💡
小技巧:

「提现快」是有效性证明最实在的用户收益;但请同时确认 prover 是谁——若证明只由项目一方生成,「有效性」的去中心化程度就打了折扣。

06

zkEVM 四类型:等价程度的取舍

登录记录进度

以太坊的 EVM 是被大量工具、编译器、合约依赖的复杂系统,想为它生成证明,工程难度极高。Vitalik Buterin 提出按等价程度把 zkEVM 分成四类,这是理解各项目定位最好的框架。

Type 1(完全以太坊等价):逐字节与以太坊一致,连区块结构、状态树都一样,好处是能直接验证主网区块、复用全部工具,代价是证明生成慢、成本高。Type 2(完全 EVM 等价):EVM 行为完全一致,但改动了一些数据结构(比如状态树)以加速证明,对开发者友好、对验证主网区块不友好。

Type 2.5:在 Type 2 基础上牺牲一点性能来降低证明成本。Type 3(几乎 EVM 等价):为便于证明去掉了少数预编译合约或边角特性,绝大多数合约能跑,少数可能不兼容。

Type 4(语言级等价):不证明 EVM 字节码,而是直接证明高级语言的编译产物(例如某条 Solidity 到内部 IR 的路径),证明最快、兼容性最需要开发者留意。越靠 Type 1,兼容性越好、证明越贵;越靠 Type 4,证明越便宜、坑越多。

💡
小技巧:

如果你要往某条 zkRollup 部署复杂合约,先查它属于哪一类、有哪些预编译不支持——Type 3/4 上遇到的兼容问题,通常不是你的代码写错了。

07

为什么「证明很贵、验证很便宜」

登录记录进度

这是 ZK 在区块链上真正值钱的经济结构,值得单独理解。生成证明(proving)需要把整批计算的每个步骤都转成约束并求解,开销常常是执行本身的上万倍——跑 1 秒的计算,可能需要几分钟甚至更长时间来证明。

但验证(verification)只需检查一个几百字节的证明,Gas 成本恒定且很小(典型在几十万 Gas 量级,与计算规模无关)。这个不对称带来三个推论:一、规模化效应——一批交易证明一次,摊到每笔交易的成本随批量增大而下降,所以 L2 希望把批次做大;二、硬件竞争——证明是算力密集任务,专业团队会用 GPU/FPGA/集群来压低单位成本,这让 prover 容易走向专业化、进而集中化;三、链上验证便宜而链下证明昂贵,所以把验证放在主网、把证明放在链下,是这门技术最自然的落地方式。

理解这个不对称,你也就能明白为什么「zkRollup 在交易量低的时候并不便宜」——固定成本需要足够多的交易来摊薄。

08

有效性证明不等于隐私

登录记录进度

这是关于 ZK 最常见、也最容易造成错误决策的误解,必须单独说清。zkRollup 里的交易数据默认仍然公开发布在主网上(否则无法验证),所以金额、地址、调用数据都是公开可查的——有效性证明解决的是「计算正确性」与「提现速度」,完全没有隐藏任何交易内容

真正的隐私需要额外机制:隐藏发送方或接收方(如隐私池、混币式设计)、隐藏金额(如机密转账方案的加密金额与范围证明)、或全部隐藏(如 Zcash 一类完全私密链)。

为什么必须分清?因为有人会因为「用了 ZK」而误以为自己的转账记录不可追溯,从而把不该混用的地址混在一起、或在上面做本该保密的操作,结果链上分析工具照样把他的资金路径连起来。判断方法很简单:去看它的区块浏览器——如果一笔转账的金额和地址都能直接查到,那它没有任何隐私保护。

🚫
避坑提醒:

不要因为项目名里带 ZK,就认为转账匿踪。 主流 zkRollup 的数据是公开的,链上分析工具能完整还原资金路径。需要保密的操作(例如把个人身份与某个地址关联)不要在公开链上做,无论这条链用了什么证明技术。

09

现状与选择建议

登录记录进度

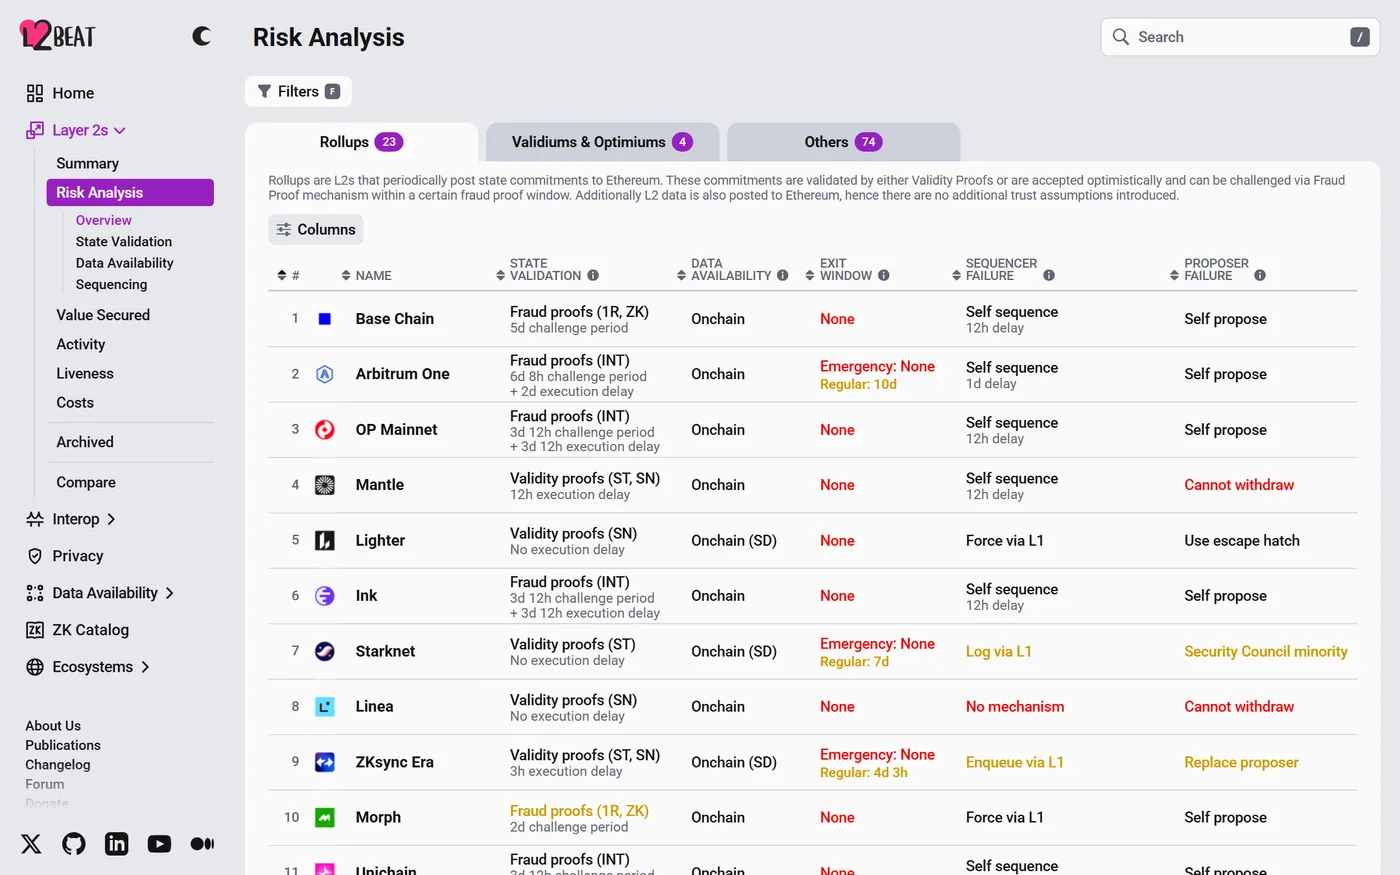
把技术差异落到实际使用上。StarkNet 走 STARK 路线、不依赖可信设置、生态与开发语言自成一套,性能取向明显;zkSync EraScrollLinea 等属于 EVM 系 zkRollup,前者自建工具链、对开发者有额外抽象,后两者强调与现有以太坊工具链兼容;Polygon zkEVM 也是 EVM 兼容路线的一员。

作为用户,你不必按证明系统选链,而是按三件事选:一、数据发布在哪里(是否上主网);二、提现延迟与桥的升级权限(能不能及时跑、谁能改规则);三、prover 是否去中心化(有效性证明的信任结构是否真的成立)。

作为开发者,还要多问一句属于 zkEVM 哪一类、有哪些预编译不支持。把这四条问完再决定投放多少资金与精力,比对着一堆「ZK、高性能、低费用」的宣传语做判断要可靠得多。

💡
小技巧:

技术细节决定上限,但资产安全由「数据在哪、谁能改桥、跑得快不快」决定。选链时先看后三条,再看技术与生态。

全部步骤已完成

操作完成后建议再核对一次到账金额与手续费,并保留交易哈希作为凭证。

相关教程

L1 与 L2 的区别:不可能三角与扩容路线
扩容方案入门25-35 分钟

L1 与 L2 的区别:不可能三角与扩容路线

从零理解区块链扩容的底层矛盾:先用通俗类比讲清「不可能三角」,再回顾比特币区块大小战争这段真实的路线之争,然后梳理 L1 自身的扩容手段(大区块、分片、并行执行、更快共识),引出 L2(第二层网络)的核心思路——把执行搬到链下、把结算与数据锚定在 L1。文中用两张 Markdown 表格对比以太坊、Solana、BNB Smart Chain、Avalanche、Sui/Aptos 的架构取舍,以及 Arbitrum、Optimism、Base、zkSync Era、Starknet、Scroll 的类型与提现时间,最后用一笔 Swap 的 Gas 账单说明 L2 到底省了多少钱,并纠正「L2 就是侧链」等常见误区。

9 个步骤
L2 与侧链技术要点:Rollup、ZK 与数据可用性
扩容方案进阶35-50 分钟

L2 与侧链技术要点:Rollup、ZK 与数据可用性

面向进阶读者的 L2 技术拆解:先给出扩容方案全景图(状态通道、Plasma、Rollup、侧链、Validium、Volition)并列出各自的信任假设,再深入 Optimistic Rollup 的欺诈证明与 7 天挑战期、ZK Rollup 的有效性证明与 SNARK/STARK 差异,用表格对比两大流派;随后讲解侧链为什么不等同于 L1 安全性(Ronin 与 Poly Network 事件的教训)、Validium 与 Volition 为低成本付出的数据可用性代价、EIP-4844 的 blob 交易与 Celestia/EigenDA/Avail 等 DA 层、排序器(Sequencer)的中心化风险与去中心化进展,最后梳理跨链桥在 L2 体系中的信任假设与常见误区。

9 个步骤
扩容方案进阶30-40 分钟

数据可用性(DA)层:Blob、Celestia 与 EigenDA

从「数据可用性」这个听起来抽象、实际决定资产安全的概念讲起:为什么 Rollup 必须把交易数据发到某个地方、EIP-4844 的 blob 交易到底改变了什么账本结构、一笔 L2 交易的费用账单里执行费与 L1 数据费各占多少。然后用三条路线对比外部 DA 方案——Celestia 的数据可用性抽样、EigenDA 的再质押担保、以及传统的委员会模式(DAC/validium),把每一条的<strong>信任假设</strong>摊开讲:你信的到底是对方链的共识、一组成员的签名,还是某个运营方不作恶。最后给出判断清单:怎样在 L2BEAT 上确认一条 L2 用的是哪种 DA,以及为什么「数据发到 blob 里」不等于「数据永久保存」。

9 个步骤